Revista del Archivo Nacional de Costa Rica
ISSN 2215-5600
Vol. 88, 2024: e614
Del 1 de enero al 31 de diciembre 2024
www.archivonacional.go.cr/RAN
Propuesta para la automatización de la evaluación de calidad de digitalizaciones del patrimonio documental usando un modelo de Deep Learning
Proposal for the automation of the quality assessment of documentary heritage digitizations using a Deep Learning model
Resumen. Se presenta una propuesta para la digitalización de documentos en soporte de papel del Archivo Nacional, enfocándose en el control de calidad de las imágenes digitalizadas, comprendiendo como se lleva a cabo esta labor actualmente y a partir de ahí se desarrolló el objetivo del trabajo que consiste en la automatización de la actividad de gestión y evaluación de la calidad de las digitalizaciones realizadas, empleando Deep Learning, a través de una herramienta gratuita y fácil manejo. Se desarrolló un modelo de aprendizaje supervisado en la plataforma Teachable Machine, de Google, para clasificar las imágenes digitales en correctas y defectuosas. Con dicha herramienta se obtuvo un 100% de efectividad, ofreciendo un parámetro como punto de partida para conocer la exactitud de este proceso.
Palabras clave. Teachable Machine; aprendizaje profundo; automatización; control de calidad; digitalización.
Abstract. A proposal is presented for the digitization of paper-based documents from the National Archive, focusing on the quality control of digitized images. This proposal encompasses the current execution of this task and develops the objective of automating the activity of managing and evaluating the quality of the digitizations performed, using Deep Learning through a free and easy-to-use tool. A supervised learning model was developed on Google’s Teachable Machine platform to classify digital images as correct or defective. With this tool, a 100% effectiveness was achieved, providing a benchmark to understand the accuracy of this process.
Keywords. Teachable Machine; Deep Learning; Automation, Quality Control; Digitization.
1. Introducción
La necesidad de acoplarse a las nuevas tecnologías y los avances que estas generan obliga a las empresas e instituciones a desarrollar herramientas que les faciliten la ejecución de sus procesos. Una de estas es la automatización, con la cual se logra simplificar la ejecución de tareas y establecer requerimientos que faciliten el cumplir con la normalización
(López, 2015).
La conservación de documentos, si bien se enfoca en conservar (valga la redundancia) el documento original, esta no escapa a las nuevas tecnologías pues a través de la preservación digital se busca “garantizar la continuidad de los elementos del patrimonio digital durante todo el tiempo que se consideren necesarios” (UNESCO, 2021, párr, 3), sin embargo también se pretende alargar la vida de los originales, manteniéndolos en resguardo mientras se facilitan reproducciones digitales, particular mente sobre los documentos con valor científico cultural, según se especifica en la Norma Técnica Nacional NTN-003: “El principal fin de la digitalización de los documentos con valor científico cultural es reducir la manipulación de los originales; lo que a su vez favorecerá su preservación” (Junta Administrativa del Archivo Nacional, 2021, p. 12).
Para esto corresponde determinar parámetros para saber no solo el formato, características y calidades en que se va a digitalizar un documento, sino que se deben establecer mecanismos para el control de calidad y con ello garantizar su visualización, así como su fiabilidad, integridad y autenticidad del documento.
En este artículo se presenta una propuesta de automatización del control de calidad de las digitalizaciones realizadas en el Archivo Nacional, mediante el empleo del Deep Learning, A partir de los resultados obtenidos en el trabajo final de investigación aplicada de la Maestría Profesional en Tecnologías de la Información y Comunicación para la Gestión Organizacional de la Universidad de Costa Rica, denominado Automatización del proceso de gestión y evaluación de la calidad de las digitalizaciones realizadas en el Departamento de Conservación de la Dirección General del Archivo Nacional utilizando Deep Learning.
1.1. Problema y justificación
En el Archivo Nacional, la reproducción digital del patrimonio documental se encuentra establecido en el procedimiento Digitalización de documentos de conservación permanente (DGAN-DCONS-PROC-011-2017), el cual se ejecuta de forma manual, incluido el control de calidad; debido al estado de conservación y la antigüedad de los documentos. Esta labor es llevada a cabo en el Área de Reprografía Documental – anteriormente Microfilmación – del Departamento de Conservación.
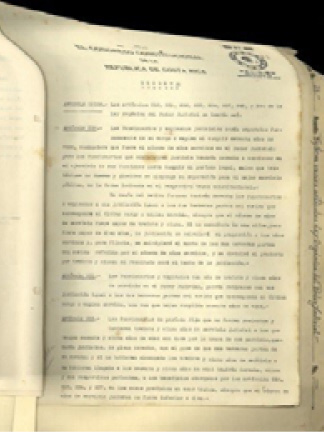
El control de calidad se ejecuta examinado las imágenes para verificar su correcta visualización y legibilidad, como se observa en la figura 1. Los parámetros para llevar a cabo el control de calidad son:
- No se permiten imágenes torcidas, borrosas o con sombras en las fuentes, ni caracteres interrumpidos o de segmentos faltantes en las líneas como resultado de la digitalización.
- No tener puntos, rayas o manchas generados en el escáner que afecten la legibilidad, es decir, cualquier signo que no se presente en el documento de origen no digital.
- No presentar la exposición de la imagen con mucha luz o muy oscura, comparadas con el documento original en papel. (Junta Administrativa del Archivo Nacional, 2021, p. 17).
Figura 1. Imagen movida defectuosa.
Fuente: Zúñiga Fallas, 2023.
Cabe mencionar que el control de calidad como tal, se lleva a cabo de la siguiente manera; cuando el documento es de 25 folios o menos se revisa imagen por imagen, para lo que puede requerirse de 30 a 60 minutos. En el caso de documentos de más de 25 folios se realiza un muestreo cada 5 imágenes, asimismo, el tiempo incrementa.
Además, es importante señalar que esta actividad se realiza de manera masiva. Esto significa que se digitaliza un volumen considerable de documentos y, posteriormente, una persona funcionaria se encarga de llevar a cabo el control de calidad. Es decir, no se realiza una verificación de calidad inmediatamente después de digitalizar cada documento.
En vista de la situación observada, se ha desarrollado una propuesta para la automatización del control de calidad de las digitalizaciones utilizando técnicas de Deep Learning. Esta iniciativa no solo contribuirá a la modernización de la actividad, sino que también permitirá agilizar significativamente la gestión global del procedimiento.
2. Metodología
La investigación se desarrolló dentro el enfoque cualitativo, ya que permite ahondar en el entorno para describir la problemática (Hernández et al., 2014). Además, es de tipo descriptivo, pues describe los eventos para luego presentar los datos (Glass y Hopkins, 1984). Propiamente para el desarrollo del trabajo se pretendió conocer la situación desde la perspectiva de los funcionarios del Área de Reprografía Documental.
Los sujetos de información fueron las personas funcionarias que al momento de la investigación se encontraban a cargo de la digitalización y control de calidad de las imágenes del patrimonio documental, a quienes se les aplicó una entrevista semiestructurada para poder obtener información de primera mano sobre el control de calidad que se lleva a cabo en la institución. Esta información se complementó con una observación directa, donde se pudo conocer más a fondo la ejecución de la actividad.
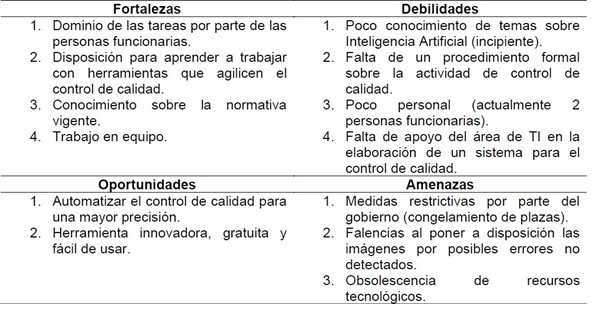
Para el análisis de los datos, se elaboró una cuadro de analisis FODA, representado en la figura 2, que proporciona una visión comprensiva de la situación mediante la recopilación sistemática de datos. Este enfoque permite identificar tanto los factores internos — fortalezas y debilidades — como los factores externos — oportunidades y amenazas — derivados de la información obtenida a partir de las entrevistas y la observación.
Figura 2. Análisis FODA.
Fuente: Zúñiga Fallas, 2023.
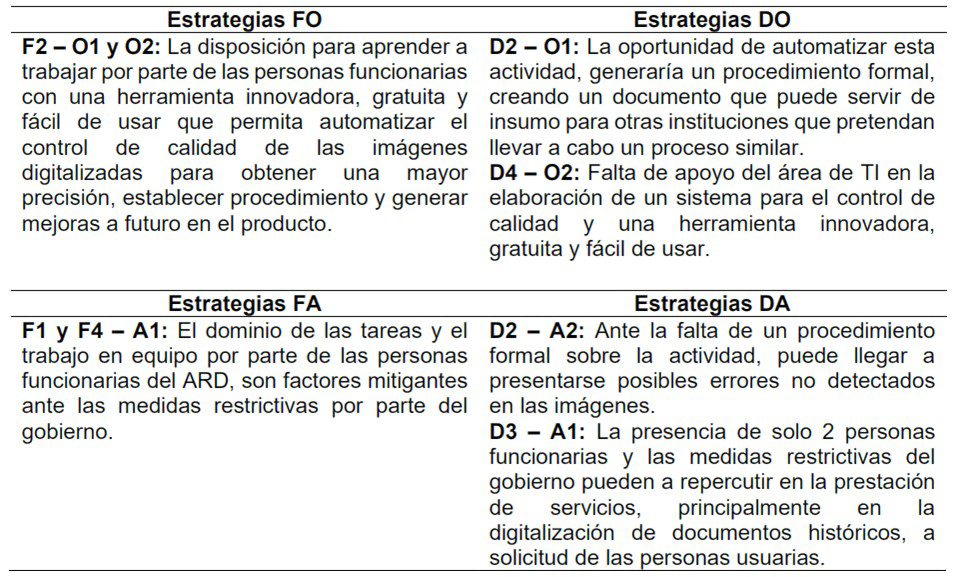
Posteriormente, se llevó a cabo la elaboración de una matriz FODA, en la cual se entrecruzaron los factores internos con los externos, permitiendo así la identificación de las buenas prácticas existentes y la detección de áreas de mejora. Este análisis también facilitó el desarrollo de una propuesta destinada a agilizar el control de calidad de las digitalizaciones mediante su automatización a través de técnicas de Deep Learning.
Para una mejor comprensión de la matriz, se empleó un sistema de codificación para identificar las estrategias, compuesto por la letra inicial del factor correspondiente y un número. Por ejemplo, Fortaleza 1 (F1), Debilidad 1 (D1), Oportunidad 1 (O1), Amenaza 1 (A1) y así sucesivamente.
Figura 3. Matriz FODA.
Fuente: Zúñiga Fallas, 2023.
A partir del análisis de esta matriz, se puede identificar una línea de éxito basada en el entrecruzamiento de F2 – O1 y O2. Este enfoque busca aprovechar el dominio de las tareas y la disposición para aprender y trabajar de los funcionarios, utilizando una herramienta innovadora, gratuita y fácil de usar. Esta herramienta facilitará la automatización del control de calidad de las imágenes digitalizadas, mejorando la precisión y estableciendo procedimientos robustos. Además, permitirá generar mejoras continuas en el producto. La combinación de estos elementos no solo facilitará la implementación del sistema, sino que también promoverá una retroalimentación constante en busca de la mejora continua.
3. Propuesta
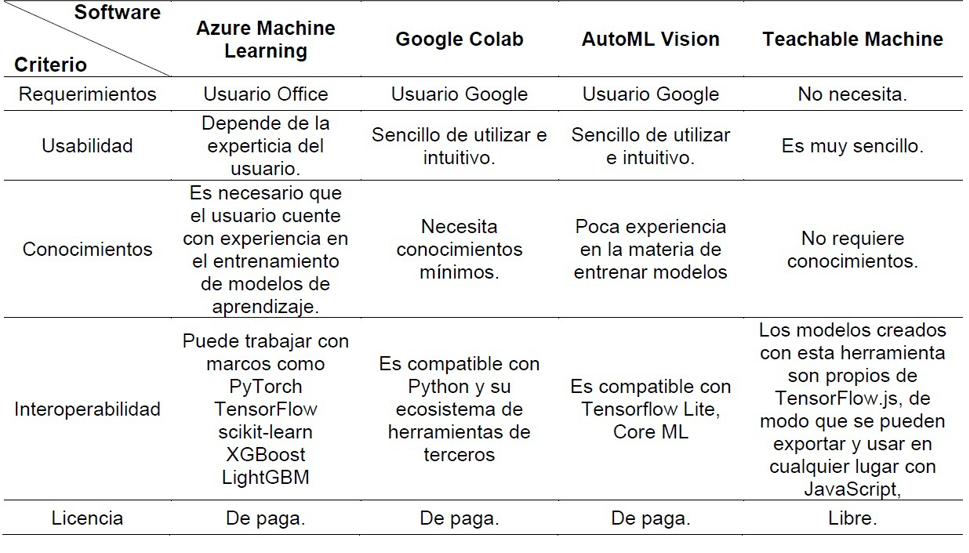
A partir del análisis FODA, con el cual se conoció la situación actual, se tomaron los insumos para iniciar la propuesta, para ello se analizaron una serie de software para determinar cuál era el más adecuado, tomado como principales elementos de selección el poco conocimiento que tenían los funcionarios y las medidas restrictivas del gasto público. En la figura 4 se pueden observar los softwares y los requerimientos necesarios para su escogencia.
Figura 4. Comparación de software.
Fuente: Zúñiga Fallas, 2023.
Tras analizar cada opción de software, se decidió utilizar Teachable Machine debido a su licencia libre. Considerando la coyuntura económica que atraviesa el país, esta elección evita la necesidad de una inversión económica por parte de la institución para implementar la herramienta. Adicionalmente, la facilidad de uso de Teachable Machine, que no requiere conocimientos en programación o en aprendizaje automático (Deep Learning), facilita su adopción por parte de las personas funcionarias, cumpliendo así con los dos requisitos principales para llevar a cabo esta propuesta.
3.1. Teachable Machine
Es una herramienta de Inteligencia artificial (en adelante IA) desarrollada por Google basada en la web y que facilita la creación de modelos de aprendizaje automáticos de manera rápida, sencilla y accesible para todos. Es de fácil uso, pues solamente se debe preparar un ordenador para que reconozca las imágenes, sonidos y posturas sin escribir código de aprendizaje automático y, posteriormente, se exporta el modelo para emplearse en diferentes proyectos y en sitios o aplicaciones, entre otros.
Esta herramienta facilita recopilar y agrupar lo que se desee que el ordenador aprenda; preparar el modelo y comprobar si hace la clasificación de imágenes, en este caso correctas e incorrectas, de forma exacta y exportar el modelado de un proyecto de forma gratuita y online (Teachable Machine, 2017).
3.2. Entrenamiento del modelo
Teachable Machine es una herramienta en línea desarrollada por Google que permite a cualquier persona, sin conocimientos avanzados de programación o aprendizaje automático, crear modelos de IA de manera sencilla e interactiva.
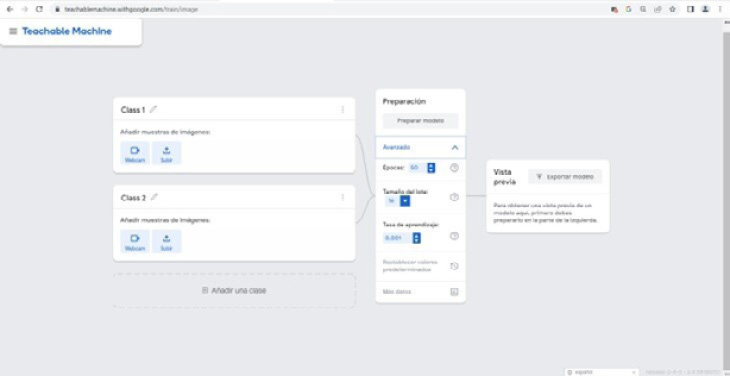
Teachable Machine presenta dos paneles que permiten entrenar el modelo según sean los requerimientos: el primero permite agregar los elementos que sirven como base para enterar el modelo y el segundo donde se realizan los ajustes de los parámetros, tal como se observa en la figura 5. Es preciso mencionar que la herramienta web cuenta con parámetros establecidos de forma predeterminada, sin embargo, estos pueden ser modificados según se necesite.
Figura 5. Interfaz de Teachable Machine.
Fuente: Zúñiga Fallas, 2023.
Para el entrenamiento del modelo de clasificación de imágenes, fue imprescindible la creación de un banco de imágenes (dataset). Este banco se estructuró en 50 épocas, donde cada época representa un ciclo completo de revisión y ajuste de parámetros con base en los datos recopilados.
Las épocas en el entrenamiento de modelos de aprendizaje automático son ciclos en los cuales el modelo examina todas las muestras de entrenamiento y ajusta sus parámetros mejorando su precisión en la clasificación o predicción de los datos, es decir, reduce el margen de error. Este proceso de ajuste continuo es fundamental para que el modelo aprenda y generalice adecuadamente a partir de los datos de entrenamiento.
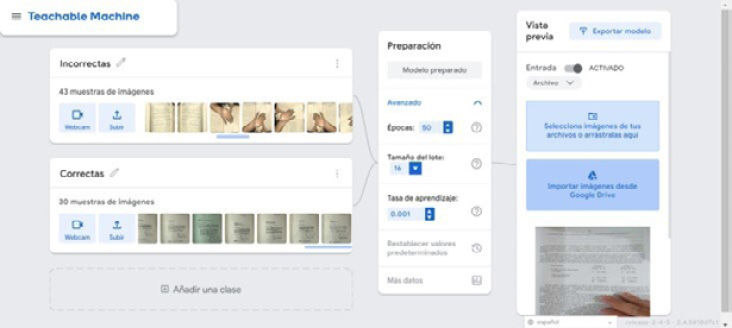
En el desarrollo de la propuesta, se utilizaron un total de 43 imágenes con errores detectados. Por ejemplo, la figura 1 se empleó para definir el parámetro de “imagen movida” entre las imágenes incorrectas, asegurando una categorización precisa de los errores.
Figura 6. Ingreso de imágenes para entrenar el modelo.
Fuente: Zúñiga Fallas, 2023.
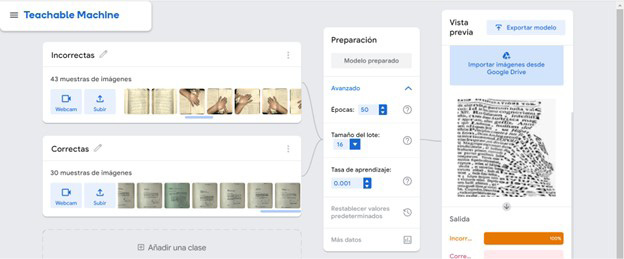
Una vez ingresadas las imágenes (figura 6), se entrenó el modelo con los datos establecidos y se realizaron pruebas para verificar su funcionamiento, tal como se puede observar en figura 7.
Figura 7. Prueba en la identificación de imágenes con errores.
Fuente: Zúñiga Fallas, 2023.
En la Figura 7 se aprecia como el modelo al ser puesto a prueba con una imagen defectuosa arroja un 100% en el área de imágenes incorrectas. Es importante acotar que, si bien se pueden aumentar las categorías de imágenes defectuosas, para esta propuesta solo se trabajó con dos categorías, imágenes correctas e incorrectas, esto debido a las pocas imágenes con que se contó al momento de entrenar el modelo.
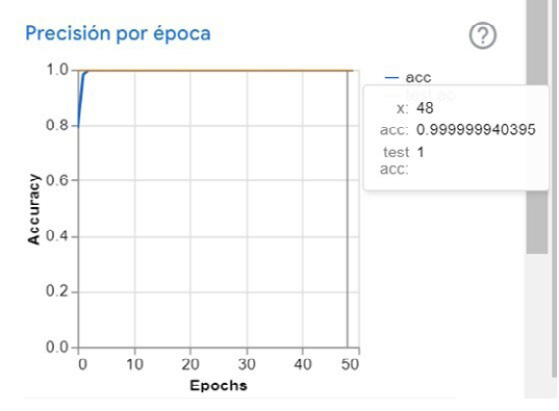
En relación con el proceso de aprendizaje del modelo, este se monitorea mediante un panel secundario que refleja su exactitud, como se muestra en la figura 8. En esta figura se presenta la precisión por época, observándose que el porcentaje de clasificación acertada es igual a 1, lo cual indica un desempeño exitoso del modelo. Cada época representa una revisión exhaustiva de todos los datos recopilados, permitiendo ajustes continuos en sus parámetros para mejorar su precisión.
Figura 8. Precisión del entrenamiento.
Fuente: Zúñiga Fallas, 2023.
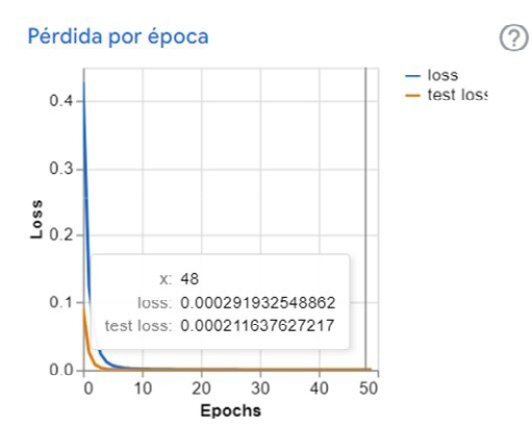
Además de su precisión como verificador, esta herramienta reporta las pérdidas por época, lo que permite calcular el nivel de aprendizaje del modelo al predecir la clasificación de las imágenes. Tal como se muestra en la Figura 9, el margen de pérdida es de 0.00029, un valor ínfimo y no representativo, lo que sugiere que las predicciones del modelo son y continuarán siendo precisas.
Cabe destacar que la exactitud (accuracy) se expresa como un porcentaje entre 0 y 1, donde un valor igual a 1 indica una predicción perfecta.
Figura 9. Margen de pérdida por época.
Fuente: Zúñiga Fallas, 2023.
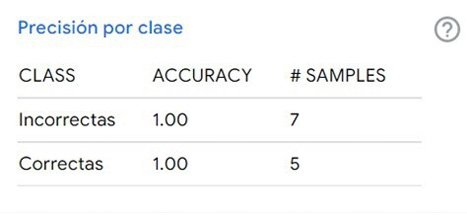
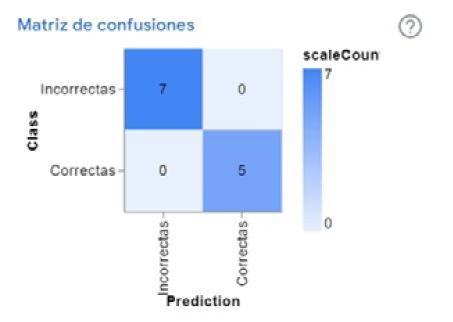
Para corroborar los datos obtenidos de los indicadores de predicción y pérdida, se recurre a la precisión por clase (figura 10) y matriz de confusión (figura 11) donde se logra visualizar el desempeño del entrenamiento que se emplea en el aprendizaje supervisado del modelo, además se logra observar que el modelo no presenta confusión con las clases, lo cual significa que el modelo realiza la clasificación correctamente.
En la figura 10, se detalla la precisión por clase, destacando la clasificación y exactitud en la categorización de las muestras. En este caso, al emplear 12 imágenes diferentes a las utilizadas durante el entrenamiento del modelo, almacenadas en el banco de imágenes, se logró una precisión de 1.00, indicando una clasificación perfecta de las imágenes en correctas e incorrectas. Este resultado presenta la capacidad del modelo para generalizar y realizar predicciones precisas, incluso con datos no vistos previamente.
Figura 10. Precisión por clase.
Fuente: Zúñiga Fallas, 2023.
En cuanto a la matriz de confusión (figura 11) se puede observar que la proyección del modelo evidencia su capacidad predictiva, indicando el nivel de precisión en relación con cada una de las clases dentro del proyecto. Este análisis subraya que las clases comparten características intrínsecamente similares, lo que sugiere que el modelo ha desarrollado una habilidad robusta para generalizar. Como resultado, el modelo puede realizar predicciones con una precisión notablemente elevada.
Figura 11. Matriz de confusión.
Fuente: Zúñiga Fallas, 2023.
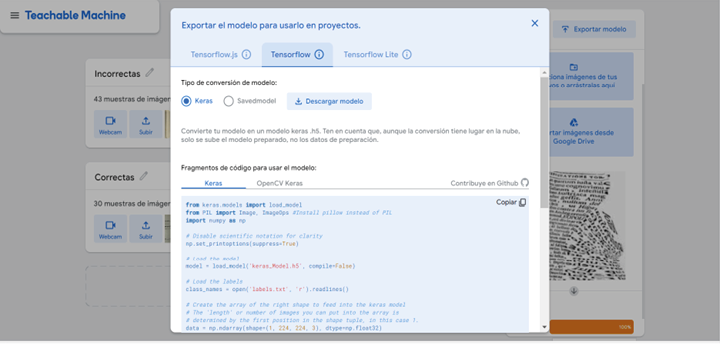
Una vez generado y entrenado el modelo, se procede a exportarlo. Teachable Machine ofrece tres opciones; Tensorflow, Tensorflow.js y Tensorflow Lite.
Figura 12. Exportación del modelo generado en Teachable Machine.
Fuente: Zúñiga Fallas, 2023.
Tensorflow es una librería de código libre para Machine Learning, multiplataforma, desarrollada por Google para solventar las necesidades generadas a partir de redes neuronales artificiales, ya que permite construir y entrenar redes neuronales para la detección patrones (Larkin, 2022).
Por otra parte, Tensorflow.js es una biblioteca de aprendizaje automático de código
abierto, basada en la biblioteca original de TensorFlow, que se ejecuta en JavaScript
(Google, 2022), mientras que Tensorflow Lite es una biblioteca multiplataforma de
Machine Learning para ejecutar modelos en, incluidos dispositivos móviles iOS y Android (LeViet, 2021). Con respecto al manejo de la herramienta, no requiere ser instalada en el equipo, ya que el modelo se puede entrenar desde su sitio web (https://teachablemachine.withgoogle.com/).
En el mismo sitio se explica cómo funciona y como exportarlo, además de la existencia de diversos tutoriales en YouTube, lo cual evitaría incurrir en costos de capacitación. Además, como se ha mencionado, es una herramienta, amigable, intuitiva y que no requiere de conocimientos en programación, lo cual facilita el proceso de aprendizaje y manejo.
4. Conclusiones
El empleo de Teachable Machine facilita significativamente la transición de procesos manuales a la automatización, ya que no demanda conocimientos previos en aprendizaje automático o programación. Además, se destaca por ser una herramienta sumamente fácil de usar e intuitiva. La implementación de esta tecnología innovadora no solo moderniza los procedimientos archivísticos, sino que establece un precedente para otras instituciones dedicadas a la preservación digital.
Aunque el uso de esta herramienta no exige conocimientos en programación, resulta ineludible la participación del Departamento de Tecnologías de la Información, dado que es el responsable de ejecutar todas las tareas relativas al ámbito de las TIC. Es imperativo que el desarrollo fomente una sinergia de trabajo entre el Departamento de Tecnologías de la Información y el Departamento de Conservación para la implementación y manejo adecuado de esta herramienta, así como para la creación de un protocolo que regule su uso.
El modelo desarrollado optimiza la automatización del control de calidad en las digitalizaciones al identificar eficazmente muestras de imágenes defectuosas. Además, al ser una herramienta de acceso libre, su adquisición e implementación no suponen ningún costo para la institución, facilitando así su integración en el proceso.
El uso de técnicas de Deep Learning para el procesamiento digital de imágenes permite detectar defectos sin necesidad de una revisión manual exhaustiva o de aplicar un muestreo que podría pasar por alto errores. Esto incrementa la eficiencia y precisión en la detección de fallos.
Los resultados obtenidos a partir de la muestra de prueba en la clasificación de ejemplares no muestran discrepancias significativas en comparación con las evaluaciones realizadas manualmente por un experto, validando así la eficacia del modelo.
La capacidad de este modelo para ser replicado en diversos contextos institucionales
abre la puerta a una transformación integral en la gestión de archivos, promoviendo la adopción de prácticas automatizadas que mejoran la calidad y fiabilidad de las
digitalizaciones.
El uso de Deep Learning en la evaluación de la calidad de las digitalizaciones no solo mejora las labores del Archivo Nacional, sino que también proporciona un marco replicable que otras instituciones pueden adoptar para elevar sus estándares de preservación digital, asegurando la conservación eficiente y precisa del patrimonio documental.
5. Referencias
Glass, G. y Hopkins, K. (1996). Statistical methods in education and psychology. Englewood Cliffs, New Jersey. Prentice-Hall.
Google Cloud. (2022). TensorFlow.js:Crea tu propia. https://codelabs.developers.google.com/tensorflowjs-transfer-learning-teachable-machine?hl=es-419#0
Hernández, R., Fernández, C. y Baptista, M. (2014). Metodología de la investigación. México: McGraw-Hill. https://www.uca.ac.cr/wp-content/uploads/2017/10/Investigacion.pdf
Junta Administrativa del Archivo Nacional. (2021). Norma Técnica Nacional NTN-003 Digitalización de documentos textuales en soporte papel del 13 de diciembre de 2021. Costa Rica. https://www.archivonacional.go.cr/index.php?option=com_content&view=article&id=142
Larkin, J. (2022). ¿Qué es TensorFlow y para qué sirve? Incentro. https://www.incentro.com/es-ES/blog/que-es-tensorflow
LeViet, K. (2021). Compila e implementa un modelo de detección de objetos personalizado con TensorFlow Lite (Android). https://developers.google.com/codelabs/tflite-object-detection-android?hl=es-419#0
López, K. (2015). Modelo de automatización de procesos para un sistema de gestión a partir de un esquema de documentación basado en Business Process Management (BPM). Universidad & Empresa. 17(29), 131-155. https://www.redalyc.org/articulo.oa?id=187243745006
Teachable Machine. (2017) ¿Qué es Teachable Machine? https://teachablemachine.withgoogle.com/faq
UNESCO. (2021). Noción de preservación digital. https://webarchive.unesco.org/web/20230612012537/https://es.unesco.org/themes/information-preservation/digital-heritage/concept-digital-preservation
Zúñiga Fallas, M. (2023). Automatización del proceso de gestión y evaluación de la calidad de las digitalizaciones realizadas en el Departamento de Conservación de la Dirección General del Archivo Nacional utilizando Deep Learning. [Tesis de maestría]. Universidad de Costa Rica. https://hdl.handle.net/10669/89398
Artículo arbitrado, sección ARCHIVÍSTICA
Max Zúñiga Fallas
M.Sc. en Tecnologías de la Información y Comunicación para la Gestión Organizacional por la Universidad de Costa Rica. Archivo Nacional de Costa Rica. [email protected] | SAN JOSÉ, COSTA RICA.
Fecha de recepción: 08/05/2024
Fecha de aprobación: 18/12/2024
INGRESE AQUÍ
INGRESE AQUÍ
INGRESE AQUÍ